AI agent 大模型实战之 RAG检索本地知识库
在构建企业级或私有化 AI 应用时,通用大模型往往缺乏特定领域的垂直知识,直接调用 API 又面临数据隐私与成本问题。本项目聚焦于 RAG(检索增强生成)技术的本地化落地,旨在解决如何让大模型精准理解并引用本地私有文档库,从而生成有依据、低幻觉的回答。它不是简单的概念演示,而是提供了一套从数据清洗、向量化存储到检索匹配的全链路工程实现,适合具备 Pytho…
在构建企业级或私有化 AI 应用时,通用大模型往往缺乏特定领域的垂直知识,直接调用 API 又面临数据隐私与成本问题。本项目聚焦于 RAG(检索增强生成)技术的本地化落地,旨在解决如何让大模型精准理解并引用本地私有文档库,从而生成有依据、低幻觉的回答。它不是简单的概念演示,而是提供了一套从数据清洗、向量化存储到检索匹配的全链路工程实现,适合具备 Python 基础、熟悉基本数据结构,并希望深入理解大模型推理背后数据流转机制的开发者。如果你已经能跑通简单的 Llama 或 ChatGLM 本地部署,但苦于无法让其回答业务专有名词,这套方案正是你需要的补充。
核心架构与关键模块
项目采用模块化设计,核心逻辑分为数据预处理、向量数据库交互和检索推理三个部分。首先,系统利用 BAAI 的 bge-large-zh-v1.5 模型作为嵌入引擎,将非结构化的本地文本(如 txt 文档)转化为高维向量。这一选择兼顾了中文语义理解的精度与推理速度,适合本地 CPU 或低端 GPU 运行。其次,使用 ChromaDB 作为持久化向量数据库,通过配置 HNSW 索引和余弦相似度算法,实现了高效的多模态数据检索。这种组合避免了依赖重型数据库集群,降低了部署门槛。代码中清晰展示了如何从文件系统读取数据、分块(Chunking)、嵌入存储以及根据用户 Query 进行 Top-K 检索。建议重点研读数据加载与向量化的衔接代码,理解分块策略对检索准确性的影响,这是 RAG 系统中容易被忽视但至关重要的细节。
实操路径与独立开发能力
学习时,建议先复现 demo 中的模型下载与向量库初始化流程,确保环境依赖正确。接着,替换示例中的 txt 文件为你自己的领域文档(如技术手册、内部 Wiki),观察检索结果的召回率变化,尝试调整分块大小和重叠率参数。通过这一过程,你将掌握如何评估 RAG 系统的效果,并学会针对特定场景优化检索策略。学完此项目,你应能独立搭建一套私有知识库问答系统,不仅限于文本,还可扩展至 PDF 或 Markdown 格式。资料中的代码结构清晰,变量命名规范,非常适合作为模板进行二次开发。你可以在此基础上接入不同的 LLM 后端,或添加重排序(Rerank)模块以提升最终答案的质量。这种基于真实代码的对照练习,比单纯观看视频更能加深对向量检索原理的工程级理解,帮助你构建真正可落地的 AI Agent 应用。
运行demo:
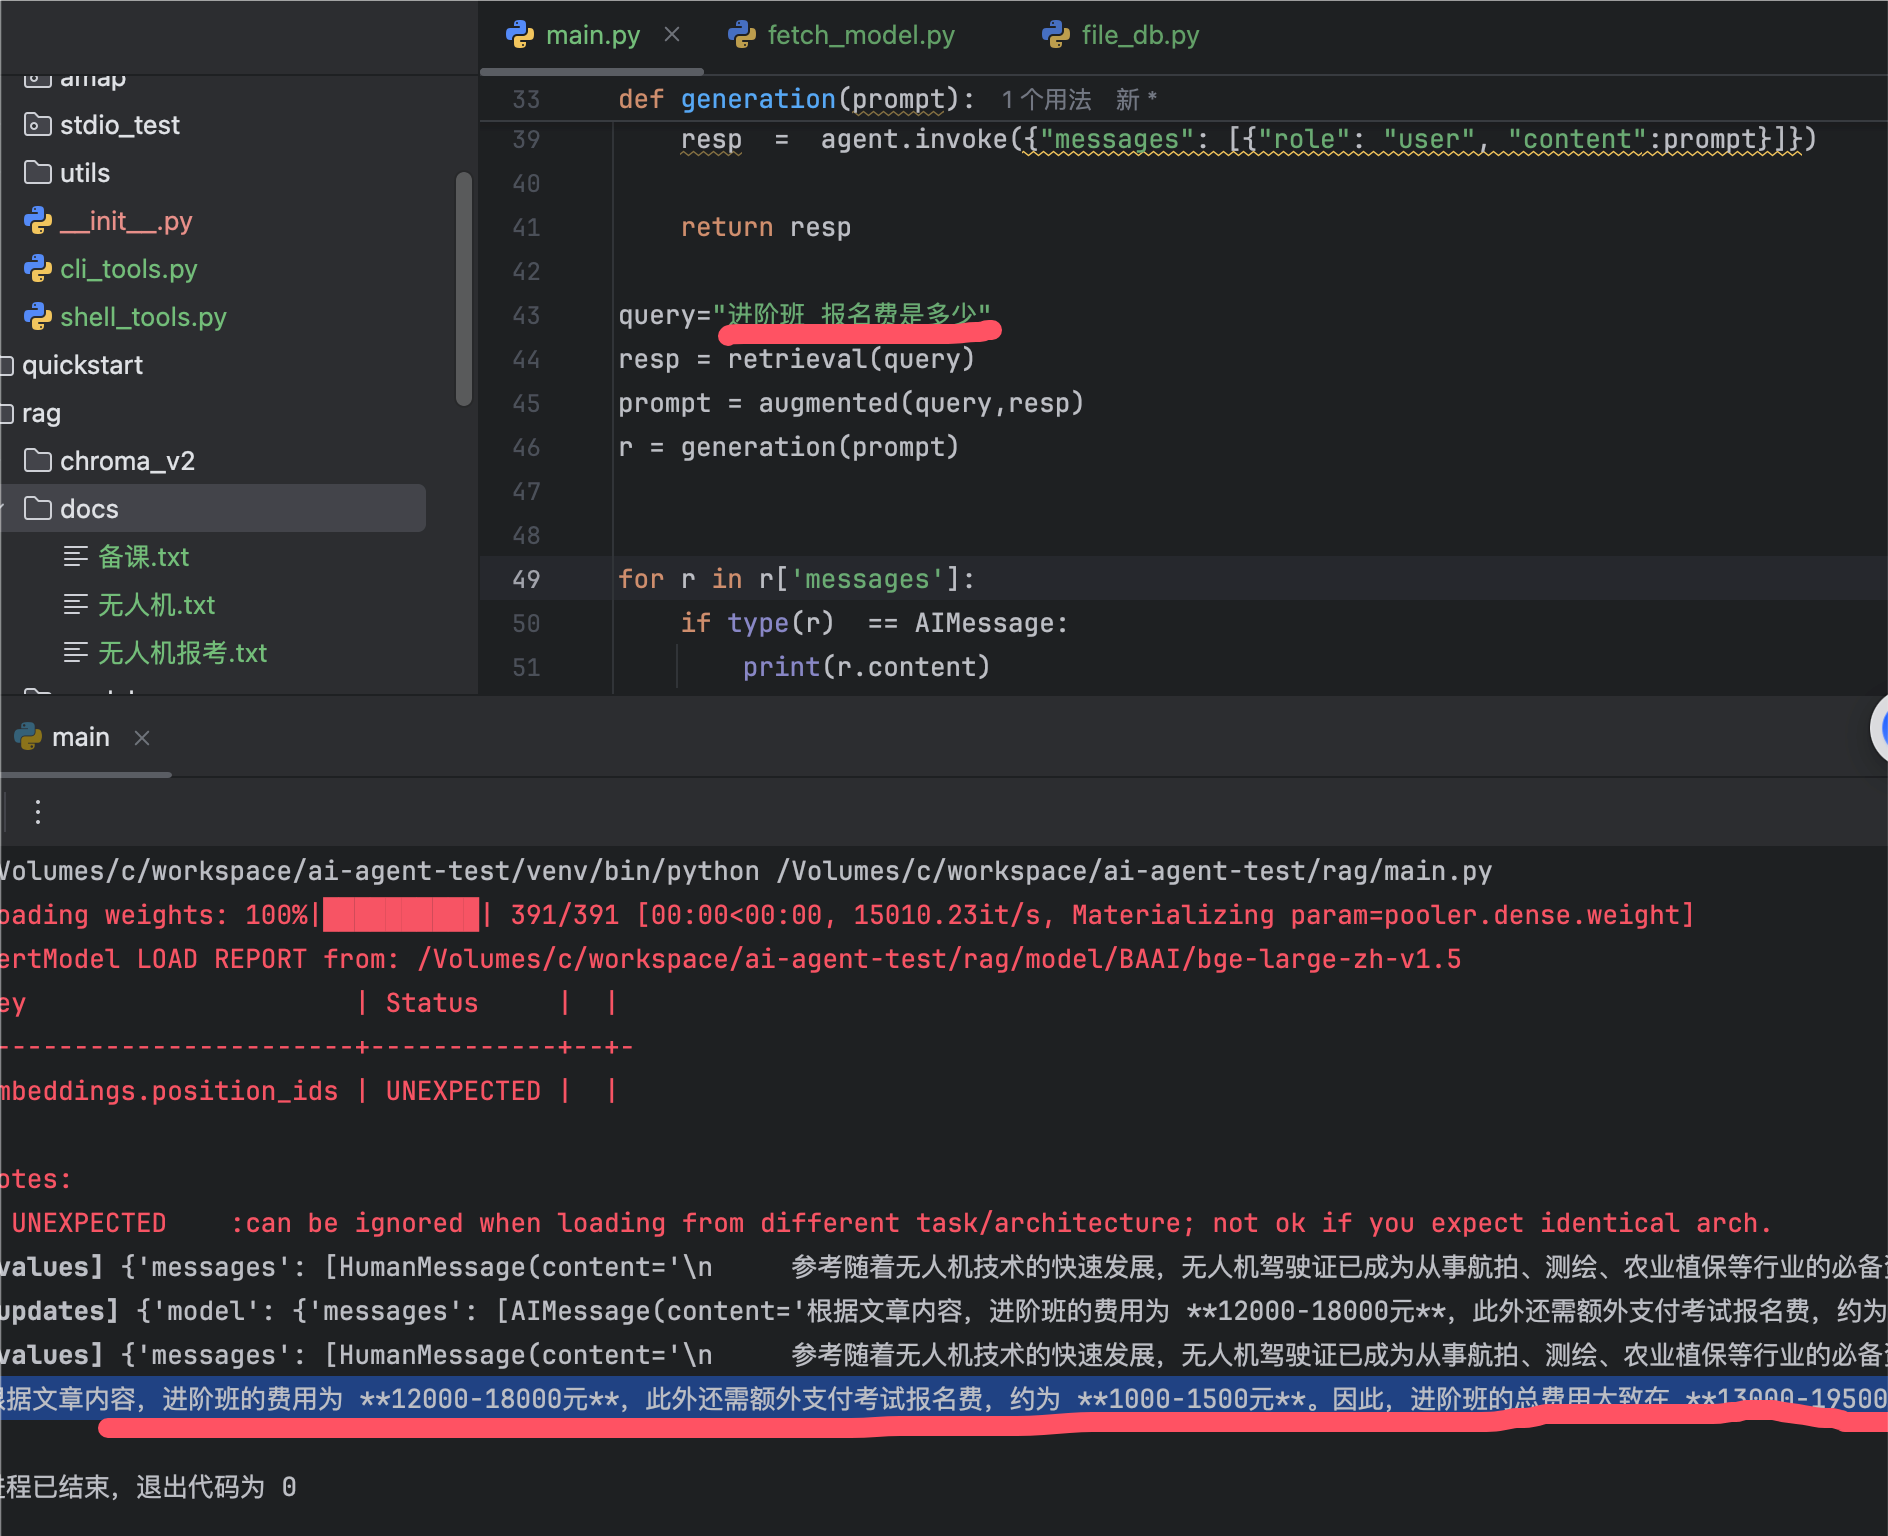
下载大模型
from modelscope import snapshot_download model_dir = snapshot_download( model_id='BAAI/bge-large-zh-v1.5', cache_dir = '/Volumes/c/workspace/ai-agent-test/rag/model'
)
安装 向量数据库chromadb
client = chromadb.PersistentClient("./chroma_v2") #文件数据库
collections = client.get_or_create_collection( name="my_db", metadata={ "hnsw:space": "cosine" } )
读取本地txt txt => embeding
path_list = list(Path("docs").glob("*.txt")) text_list = [] for path in path_list: text = path.read_text(encoding="utf-8") text_list.append(text) embeddings = model.encode(text_list) #进行向量嵌入 collections.add( embeddings=embeddings.tolist(), documents=text_list, metadatas=[{"id":i} for i,_ in enumerate(text_list)], ids=[f"doc_{i}" for i,_ in enumerate(text_list)], ) print(f"数据库中的数据量:{collections.count()}")查询 embeding => txt
query=["2023.12.1 做了什么"]
query_embedding = model.encode(query)
data = collections.query(query_embedding.tolist(),n_results=5)