 正版资源
AI agent 大模型实战之 实战langchain集成RAG检索本地知识库
构建能够准确回答垂直领域问题的 AI 应用,核心难点往往不在于大模型本身,而在于如何高效地让模型“读懂”并检索私有数据。这套实战资料聚焦于 LangChain 框架与 RAG(检索增强生成)技术的深度集成,旨在解决通用大模型在处理本地知识库时存在的幻觉问题和数据时效性滞后问题。它不追求泛泛而谈的概念
构建能够准确回答垂直领域问题的 AI 应用,核心难点往往不在于大模型本身,而在于如何高效地让模型“读懂”并检索私有数据。这套实战资料聚焦于 LangChain 框架与 RAG(检索增强生成)技术的深度集成,旨在解决通用大模型在处理本地知识库时存在的幻觉问题和数据时效性滞后问题。它不追求泛泛而谈的概念科普,而是直接切入工程落地的核心环节:如何将非结构化的本地文本数据转化为可被向量数据库高效检索的 Chunk,并通过 LangChain 的 Agent 机制,让大模型在回答前自动执行检索动作,从而基于真实上下文生成答案。
这套内容适合已经具备 Python 基础,且对 LangChain 基本 API 有初步了解,但尚未独立搭建过完整 RAG 链路的开发者。如果你能看懂 `import` 语句,理解异步编程 `asyncio` 的基本逻辑,并熟悉 `Path` 等标准库操作,就可以开始学习。对于完全的新手,建议先补全 LangChain 的核心组件概念,如 Prompt、Chain 和 VectorStore,再进入此实战,否则容易陷入代码细节而忽视架构逻辑。
建议优先研读项目中关于文本加载与切分(Text Splitting)的部分。这是 RAG 系统的基石,资料中展示了如何使用 `RecursiveCharacterTextSplitter` 处理不同格式的文档,以及通过 `DirectoryLoader` 批量读取本地文件。理解切分策略(如 chunk_size 和 overlap 的选择)对最终检索效果影响巨大。紧接着,重点分析 Agent 的创建与执行流程,特别是 `create_agent` 如何整合检索工具。观察代码中如何通过 `ChatPromptTemplate` 定义交互逻辑,以及 `asyncio` 在并发处理检索请求时的应用,这部分展示了从同步演示代码向生产级异步架构过渡的关键细节。
学完这套资料,你应当具备独立搭建一个“本地知识库问答助手”的能力。具体而言,你可以自行配置向量数据库,导入自己的技术文档或业务数据,并编写一个前端接口,让用户通过自然语言提问,系统自动在后台检索相关片段并生成引用来源明确的回答。此外,你还能根据具体场景调整 Agent 的行为逻辑,例如增加多轮对话记忆或修正检索不准确的反馈机制。
在练习时,不要只是运行现成的 Demo。试着替换其中的数据源,用你自己的 Markdown 或 PDF 文件替换示例文本,观察切分后的向量在检索时的表现。修改 Prompt 模板,测试不同表述方式对最终答案准确性的影响。通过这种“改参数、换数据、调逻辑”的反复调试,你才能真正掌握 RAG 系统的调优技巧,将这份源码转化为可复用的工程模块,而不是仅仅停留在“跑通代码”的层面。
实战demo
import asyncio
import sys
from operator import itemgetter
from pathlib import Path
from langchain_core.prompts import ChatPromptTemplate, FewShotPromptTemplate, PromptTemplate, ChatMessagePromptTemplate
from langchain.agents import create_agent
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_community.document_loaders import DirectoryLoader, TextLoader
from langchain_huggingface import HuggingFaceEmbeddings
from langchain_chroma import Chroma
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough from common import llm embedding_model = HuggingFaceEmbeddings( model_name=r'/Volumes/c/workspace/ai-agent-test/rag/model/BAAI/bge-large-zh-v1.5') vector_store = Chroma(embedding_function=embedding_model, persist_directory='./chroma_v3') # 数据库 def test(): retriever = vector_store.as_retriever(search_kwargs={"k":5}) prompt_template=PromptTemplate.from_template(""" 你是一个严谨的RAG助手 请根据以下提供的上下文信息来回答问题 如果上下文信息不足以回答问题,请直接说 无法回答 如果回答使用了上下文中的信息,在回答后输出使用了哪些上下文 上下文信息: {context} -------------------- 问题:{question} """) chain ={"question":RunnablePassthrough()} | RunnablePassthrough.assign(context=itemgetter("question") | retriever) | prompt_template | llm | StrOutputParser() resp = chain.invoke("周杰伦出生于什么地方") print(resp) #初始化 知识库
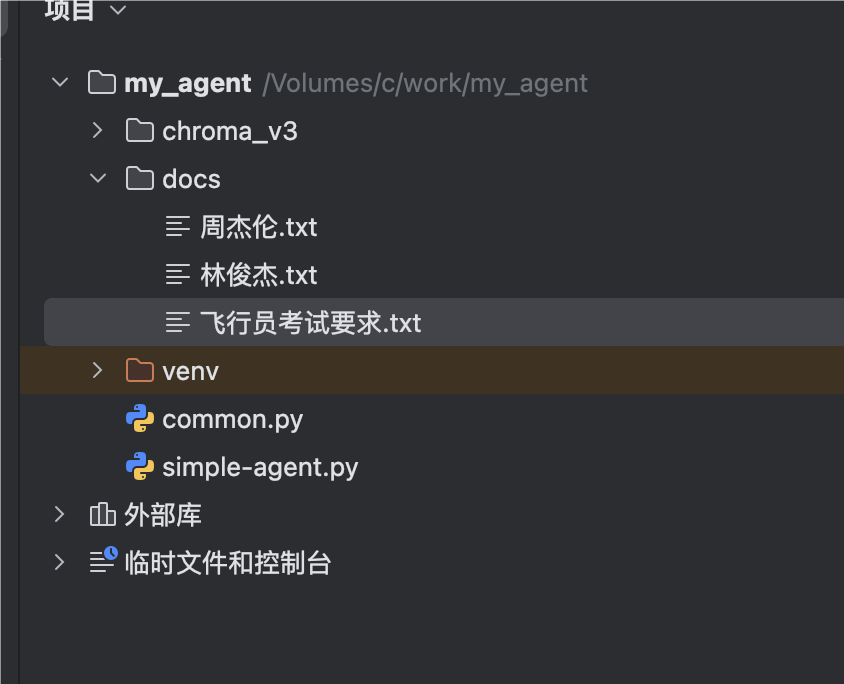
async def init(): # 获取本地知识库 file_dir = Path("docs") # 定义滑动窗口/切分 text_splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=100) # 加载文件 docs = DirectoryLoader(str(file_dir),loader_cls=TextLoader).load() # 切分文件 docs = text_splitter.split_documents(docs) # 存入数据库 await vector_store.aadd_documents(docs) #asyncio.run(init()) 执行一次知识库存进数据库
#init()
test()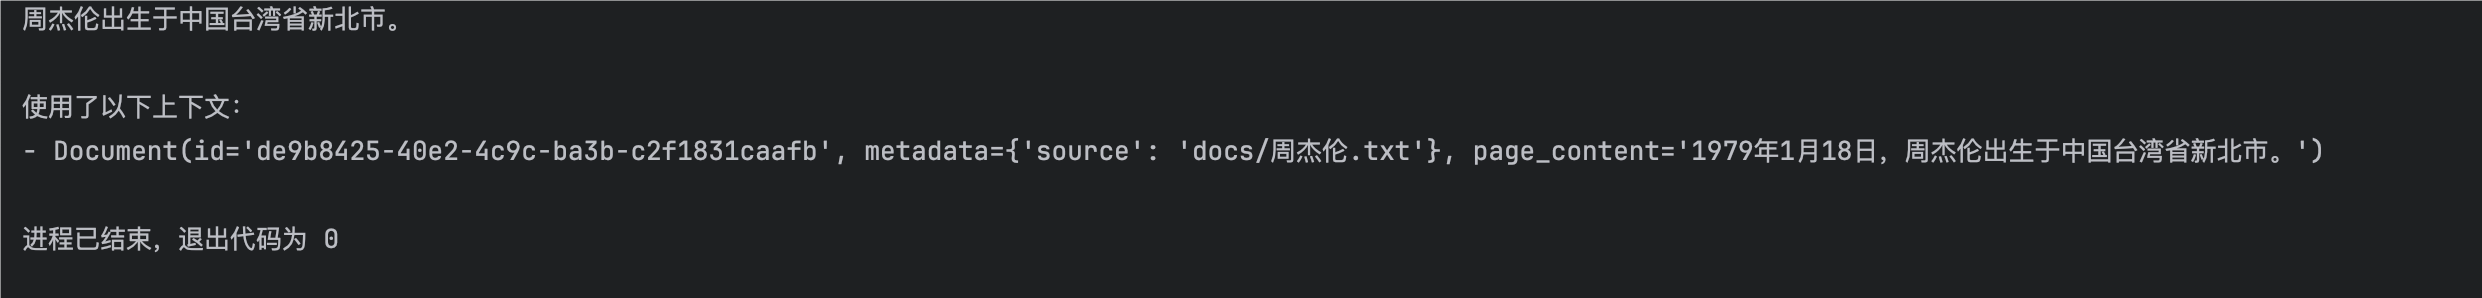
同类课程
和你正在看的这门一个方向 我的博客
AI agent 大模型实战之 RAG检索本地知识库
永久有效 · 网盘发货
 我的博客
AI agent 大模型实战之 多伦对话实现
永久有效 · 网盘发货
 我的博客
AI agent 大模型实战之 PythonPerlTool自动编写网站
永久有效 · 网盘发货
 我的博客
AI agent 大模型实战之 基于高德MCP的复杂路径规划+可视化展示
永久有效 · 网盘发货
 我的博客
AI agent 大模型实战之 Agent内存记忆能力实现
永久有效 · 网盘发货