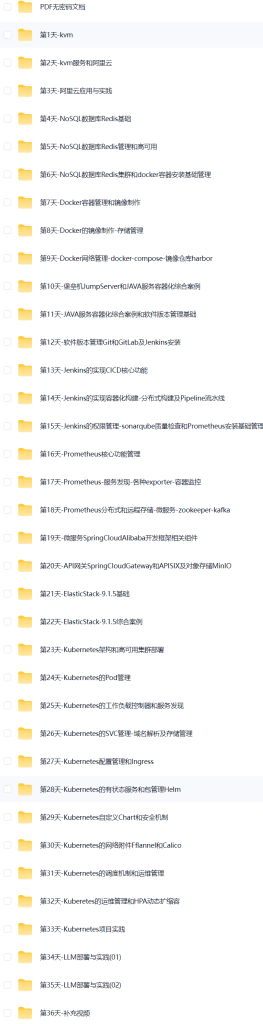
2025年11月SRE+AI智能运维架构班
这门课解决什么问题 现代互联网系统规模庞大,传统运维高度依赖人工经验,面对复杂故障排查慢、成本高,且缺乏系统性的稳定性保障机制。这门课聚焦SRE(站点可靠性工程)与AI智能运维(AIOps)的架构融合,旨在解决从基础设施监控、告警降噪到故障自愈的工程化落地难题。你将获得一套可落地的架构参考,将稳定性保障从被动救火转变为主动防御与智能自愈,覆盖可观测性、错误…
这门课解决什么问题
现代互联网系统规模庞大,传统运维高度依赖人工经验,面对复杂故障排查慢、成本高,且缺乏系统性的稳定性保障机制。这门课聚焦SRE(站点可靠性工程)与AI智能运维(AIOps)的架构融合,旨在解决从基础设施监控、告警降噪到故障自愈的工程化落地难题。你将获得一套可落地的架构参考,将稳定性保障从被动救火转变为主动防御与智能自愈,覆盖可观测性、错误预算、告警治理到自动化故障处置的完整链路。
适合什么基础与建议先看哪几块
适合具备后端开发或运维基础、熟悉Linux命令与至少一种主流编程语言(如Go或Python)的开发者。如果你已经了解基本的系统架构和监控概念,可以直接进入核心模块。建议优先阅读SRE工程化基础与可观测性架构部分,这部分为后续AI运维模块奠定了数据采集、指标聚合与日志分析的基础;随后重点攻克AIOps智能调度与故障自愈模块,理解算法如何结合业务指标进行异常预测与自动处置,以及SLO与错误预算策略如何驱动工程决策。
学完能独立做什么与资料配合练习
学完本课程,你将能独立设计系统的SLO与错误预算策略,搭建全链路的监控告警体系,并编写自动化运维脚本实现常见故障的自动恢复。资料包以源码和架构设计为主,配合练习时,建议直接对照提供的代码骨架修改并运行可观测性组件或告警规则引擎,通过手写核心逻辑来深化对架构的理解;在AI运维部分,可结合提供的算法接口与日志数据集,动手实现告警聚类或异常检测的调参,将理论架构转化为可运行的工程系统。